从SRE实践角度看新加坡机房运维的可靠性工程实现路径
回答:首先,需要明确业务关键路径与用户感知指标,常用的有请求成功率、95/99延迟、可用性等。采用SRE的做法是用SLO来表达用户可接受的服务质量,再把SLO转化为错误预算(Error Budget)以驱动发布与变更节奏。
步骤包括:1) 与产品方协同定义关键用户旅程;2) 为每个旅程设定代表性指标并采样;3) 制定SLO值(例如 99.95%)并计算错误预算;4) 将错误预算纳入发布管控和回滚策略。
新加坡机房对低延迟、亚太合规、互联互通(Peering)要求高,SLO应考虑跨区域网络波动和国际链路抖动对体验的影响。
将SLO/错误预算与事故响应挂钩:当错误预算消耗率高时,触发发布冻结并优先处理回退或缓解措施。
回答:SRE强调设计容错而非仅靠应急修复。对新加坡机房,要考虑机房内冗余、电力与网络多路复用、跨机房或跨可用区部署,以及混合云策略以降低单点故障风险。
采用多可用区(AZ)或多数据中心(DC)拓扑,结合负载均衡和流量拆分策略,确保单点失效不会影响整体服务。
实现多运营商互联、动态路由(BGP策略)和链路质量监测,使用灰度流量转移与回退机制应对国际链路抖动。
在新加坡,高可用设计需要与成本、数据主权和运维复杂性平衡,SRE应以错误预算为依据决定冗余级别。
回答:可观测性包含指标(metrics)、分布式追踪(tracing)、日志(logs)三支柱。告警要基于SLO而不是单点指标,避免告警疲劳,同时支持自动化响应。
收集业务层与基础设施层关键指标(请求率、错误率、延迟、队列长度、CPU/磁盘/网络),并建立SLO视图、错误预算面板。
启用分布式追踪(例如OpenTelemetry)以定位跨服务延迟;日志采用结构化、采样与索引策略,确保在新加坡机房本地可快速检索。
基于SLO阈值设置告警分级:信息级、警告级、紧急级;结合抑制、抖动过滤与安静时段,减少误报并提高MTTR。
回答:自动化是SRE的核心。建立基于基础设施即代码(IaC)、可重复的部署流水线与自动回滚机制,减少人为操作带来的风险,提高部署安全性与频率。
用Terraform/Ansible等工具管理网络、安全组、负载均衡与实例,变更通过审查与流水线执行,保证环境一致性。
实现蓝绿/金丝雀发布,结合错误预算自动决定是否扩展或回滚,并在新加坡机房预先跑流量验证。
构建自动化runbooks与自愈脚本(如重启容器、扩大副本),并把这些操作纳入审计与权限控制,提高可重复恢复能力。
回答:新加坡对数据主权、隐私与金融/健康类合规要求严格。SRE在设计可靠性工程时必须同时满足合规和安全要求,同时关注运维人员的可用性和心理负担。
确认机房数据流向,采用加密、最小权限和审计跟踪,满足PDPA等本地法规以及客户行业合规需求。
把安全能力嵌入CI/CD(安全扫描、依赖审计)、网络分段、WAF与入侵检测,以及定期演练灾备演习(DR drills)。
推行以SRE为核心的事故后复盘文化(Postmortem),改善心理安全与知识共享,避免单人知识孤岛,提升团队整体可靠性能力。
-
电商促销期间高防新加坡服务器如何应对流量暴涨问题
1.场景概述:电商促销流量特点与风险 1) 电商促销时间集中,短时间内并发用户数和请求速率突增。 2) 常见峰值包括并发用户10万~200万、带宽突增到数Gbps级别。 3) 风险类型:正常流量冲顶、爬虫/刷单、DDoS攻击和应用层爆发。 4) 新加坡节点优势:地理位置靠近东南亚用户、低延迟与成熟的海底光缆。 5) 预估必须准备的能力:PPS处理、2026年9月28日 -
小公司如何通过新加坡站群服务器租用实现低成本海外部署
问题一:为什么选择新加坡站群服务器租用能实现低成本海外部署? 选择新加坡站群服务器租用主要基于地理位置、网络互联与成本效益。新加坡处于亚太网络枢纽,带宽质量高、延迟低,利于面向东南亚和大中华区用户的服务响应。同时,市场上提供商多,竞争使得租用价格具有优势,适合预算有限的小公司。 要点解析 新加坡的带宽与国际出口稳定,供应商支持灵活计费(按流量2026年6月30日 -
新加坡csgo服务器的选用对竞技水平的影响探讨
引言:服务器选用的重要性 在当前电子竞技的浪潮中,新加坡CSGO服务器的选用对玩家的竞技水平产生了重要影响。选择一个合适的服务器不仅能提高游戏的流畅度,还能在一定程度上提升玩家的竞技表现。最佳的服务器往往具备低延迟和高稳定性的特点,而最便宜的服务器则可能在性能和体验上有所妥协。因此,合理选择服务器成为每位CSGO玩家必须面对的挑战。 新加坡服2025年8月26日 -
新加坡二手服务器转让市场的现状与机会
新加坡二手服务器转让市场的现状与机会 在信息技术飞速发展的今天,二手服务器的需求日益增加。新加坡作为一个全球性的科技中心,其二手服务器转让市场正面临着前所未有的机遇与挑战。本文将深入探讨该市场的现状,并分析未来的机会。 以下是本文的三个精华要点: 新加坡的二手服务器市场正在迅速增长,吸引了大量投资。 对企业而言,选择合适的2025年12月28日 -

新加坡云服务器价格表
新加坡云服务器价格表 云服务器是一种基于云计算技术的虚拟服务器,它可以在云平台上提供各种计算资源和服务。新加坡作为东南亚地区的科技中心,拥有先进的网络基础设施和数据中心,吸引了众多企业和开发者选择在新加坡建立云服务器来托管网站和应用程序。 新加坡云服务器的优势在于其稳定2025年2月10日 -
在哪里租用新加坡服务器的安全合规与数据主权问题应如何考量
1. 在新加坡租用服务器时应优先考虑哪些法规与合规要求? 在决策租用位置时,首要评估的是当地和跨境相关的法律要求。对于在新加坡设立或托管数据的服务,需关注新加坡个人数据保护法(PDPA)、金融行业监管(如MAS指引)、以及可能适用的国际标准(例如GDPR若涉及欧盟公民数据)。 要点梳理 1)审查数据类型:确定是否包含个人身份信息(PII)、医疗2026年8月12日 -
新加坡高效机房的要求与建设标准详解
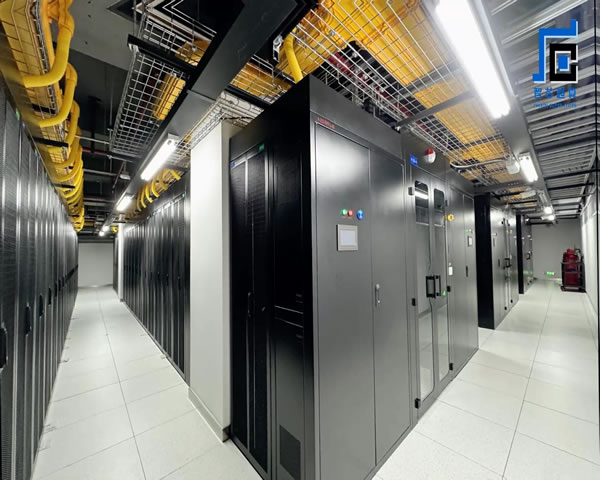
新加坡的高效机房在现代信息技术发展中扮演着至关重要的角色,其建设标准和要求直接影响着服务器的性能、稳定性和安全性。在选择高效机房时,企业需要关注多个维度,包括电力供应、冷却系统、网络连接和安全性等因素。德讯电讯作为专业的高效机房服务提供商,在这些方面具备丰富的经验和技术实力。 在高效机房中,电力供应的稳定性是首要考虑因素。机房应具备双路供电系统,以2025年8月1日 -

如何选择新加坡服务器
如何选择新加坡服务器 在选择新加坡服务器之前,首先需要明确自己的需求。考虑以下问题: 你需要托管什么类型的网站或应用程序? 你的目标用户在哪个地区? 你对服务器的性能和稳定性有什么要求? 在选择新加坡服务2025年4月5日 -
如何选择适合的新加坡站群服务器以提升网站性能
选择合适的新加坡站群服务器是提升网站性能的关键因素之一。通过优化服务器的选型,您不仅可以提高网站的加载速度,还能保证网站的稳定性和安全性。本文将为您详细介绍在选择服务器时需要考虑的几个重要方面,并推荐德讯电讯作为理想的服务提供商,以满足您的需求。 服务器类型的选择 在选择新加坡的站群服务器时,首先要考虑的是服务器类型。不同的服务器类型适用2026年1月16日